網路書店的書籍資料內容爬蟲,包含:價位、書籍簡介、摘要、出版社與ISBN等等
- 網路書店官網網址在此:Touch me
經過三個月的爬蟲工作,從一開始不知從何下手,到現在一般的網站資料爬取應該沒什麼大問題,以下將會分享一些我收藏的資源與進行爬蟲時的一些小心得。
希望整理出網路書店刊登販售的書籍內容資料進行文字資料分析,並且整理成一份可以進行資料分析的資料集,利用此資料挖掘網路商店的書籍銷售訊息。
Requests 與 BeautifulSoup 這兩個套件在Python crawler世界中扮演著關鍵性的角色。
Requests 套件主要是用來對欲爬取資料的網站後台發出請求,並幫助我們確認該網頁是否可以正常連接。
BeautifulSoup 則是解析欲分析的網頁原始碼,使得我們可以獲得乾淨的網頁原始碼後便可以藉由尋找標籤的方式找出我們有興趣的資料。
Captcha 俗稱驗證碼,其實算是一個小魔王,如何有效得突破驗證碼登入該網站後來爬取資料,應該是很多人煩惱的點,在這邊提供一個較為簡單的方式來突破,但是相對的也有其缺點。
相關學習資源網址整理如下:
-
Requests
-
BeautifulSoup
-
Captcha
-
p.s. 原諒小弟沒有遵守Pep8
- 觀察刊登書籍的網址規律
- 將所有書籍的網址寫出成檔
- 藉由迴圈將每個網址的內容擷取欲搜集部分
- 寫成csv檔
其實就是寫了兩支.py檔,第一支寫爬取所有書籍的連結寫成檔案,第二支讀入連結檔案以迴圈的方式逐一進入書籍網址進行爬蟲。
菜鳥經過一段時間的琢磨後,其實在整個過程中多多少少會有許多做白工的地方,造成你花費很多時間的主要因素中,我自己認為在於對欲爬取網站的網站觀察。
在開始爬蟲之前,應該花費最多的時間在觀察目標網站的網址規律,舉例而言:網路書店官網內有各種大類別,每一個大類別又有子類別;子類別中又存在小類別,類別連接到最後才是一本一本的刊登書籍,點入這些書籍後就是我們的爬取目標,所以要如何得到每一本書的內容頁面網址,進而一次爬取全部的書籍內容,這取決於對網站的觀察與是否發現規則。
- 如何確定這是找到了所有書籍內容的網址?
- 有沒有可能爬到重複的書籍?
- 資料寫成什麼型態的檔對於分析者而言在清理資料與分析資料時能更加順手?
- 是否有把網頁中所有有價值的資料擷取下?
- 希望整理出哪些有價值的feature
- ....
當進行一個大型網站的爬蟲時,你會常常問自己以上的問題,而這些問題的答案有時來自於官方內部或者是由網站的規律中觀察而得。目前爬取的網頁中,感到最困難的反而不是程式的bug,而是發現網站的規律與特性。
在 Requests 與 BeautifulSoup 的協助下,能夠很容易的得到網頁的原始碼,接下來的大部分時間都會花在網頁原始碼的ETL,與熟悉python在資料整理方面的學習。
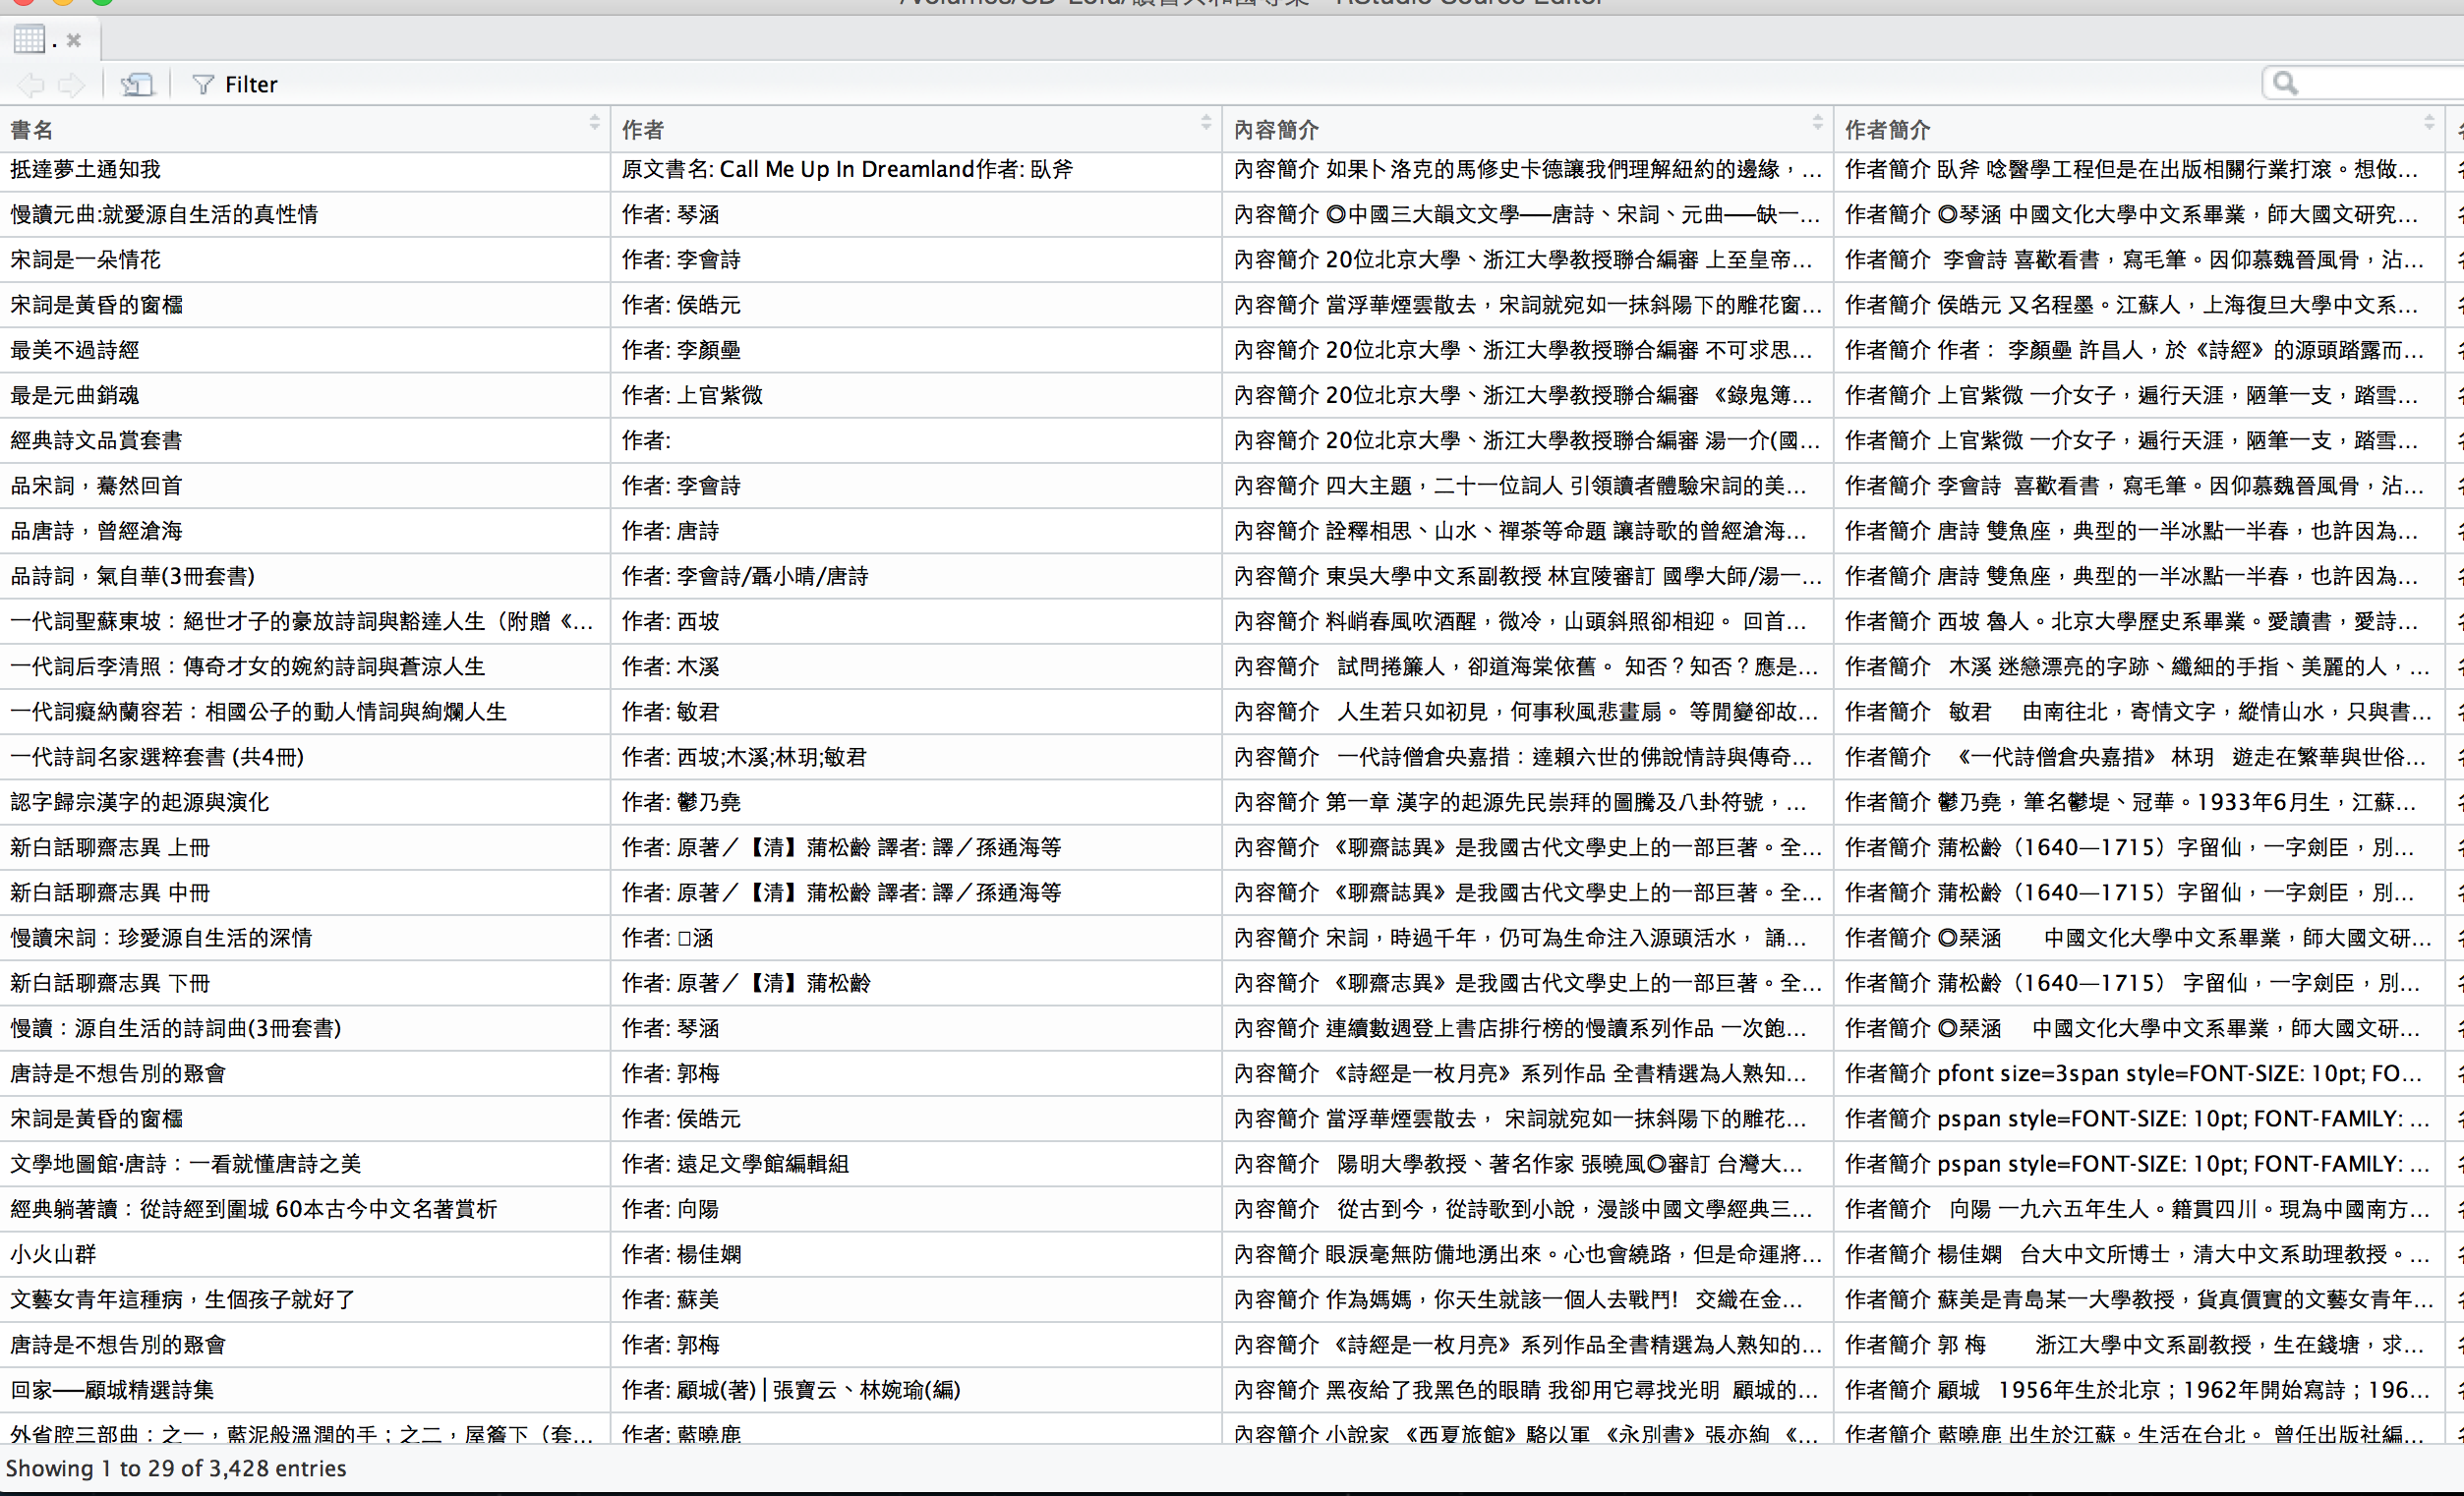
最後,爬下來的資料結果如下圖所示,原始資料的樣貌把一些不需要的標題也爬入,但可以很容易地用一些簡單的資料清理程式碼快速將之集體清理掉。